日本語版
最新ニュース
日本

MicrosoftがAzure向けの新型AIアクセラレータ「Maia 300」を発表、2027年から導入予定

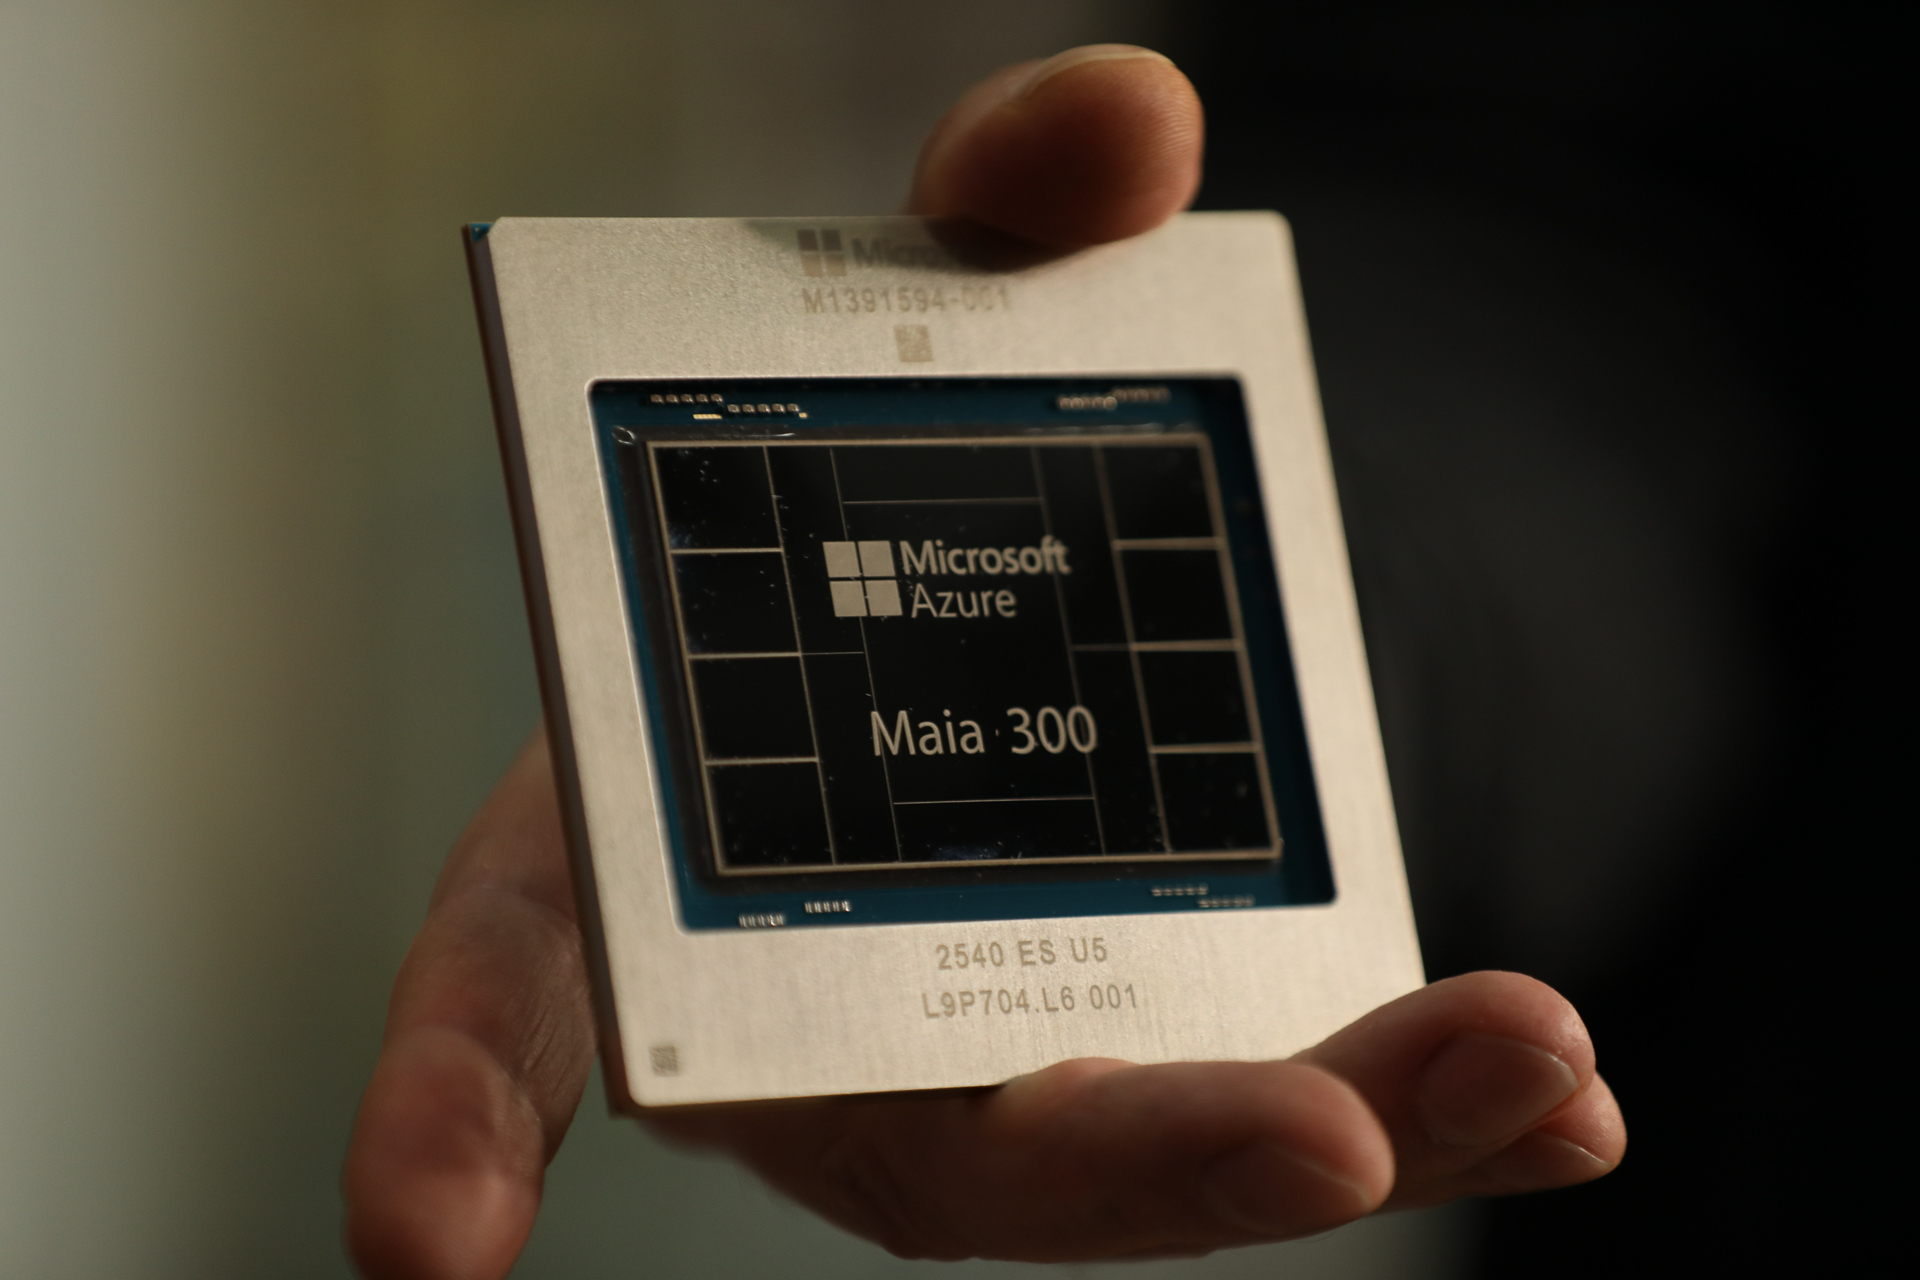
Microsoftは10月12日、Azure向けの新型AIアクセラレータ「Maia 300」を発表した。PC Watchの報道によると、前世代の「Maia 200」から約9カ月という短期間での投入となり、2027年から同社のデータセンターなどに順次導入される予定だという。 Maia 300のチップレット構造と最先端プロセスの採用 Microsoftが発表したMaia 300は、複数ダイによるチップレット構造を採用している。Maia 200まではパッケージ上に混載されるHBMを除いてシングルチップ構成だったが、Maia 300ではコンピュートダイ、4つのメモリコントローラダイ、2つのIOダイ、8つの積層HBMなどが1つのパッケージに混載される。メインの演算器となるコンピュートダイは、TSMCの最先端プロセスノードであるN2Pで製造される。メモリも強化されており、Maia 200のHBM3eから、Maia 300ではHBM4で288GBとなっている。メモリ帯域幅もMaia 200の7TB/sから18TB/sへ倍以上に引き上げられた。こうした強化により、MXFP4利用時のスループットは13.8POPSに、FP8利用時は6.9POPSに向上している。 400GbEとラックあたりの搭載数の拡大 Maiaシリーズでは400GbitのEthernetを利用してスケールアップが実現されている。Maia 200では28ポートの400GbEをサポートしていたが、Maia 300では32ポートに増やされている。また、Maia 200では1ラックあたり最大48基までだった格納数が、Maia 300では1ラックあたり最大96基へと倍増した。1つのブレードあたり4基、24ブレード構成となる。ラックあたりの消費電力は167kWに達するが、これによりGPUなどに比べて1メガワットあたりで処理できるトークン数が40%増加すると説明されている。さらに、最大128のラックを1つのスケールアップネットワークとして利用できる「2階層スイッチ」の仕組みも用意され、最大12,288基までの大規模なポッド構成を容易に構築可能になっている。 クラウド事業者におけるカスタムシリコン開発の背景 AIの学習や推論がNVIDIA製GPU上で演算されていることは既知の通りであり、NVIDIAに空前の利益をもたらしている一方で、AIモデル開発や推論環境を提供するクラウドサービス事業者には重い導入コストがのしかかっている。Google Cloudは2016年からTPUを導入しており、今年4月には第8世代のTPU 8tやTPU 8iを発表した。AWSもTrainiumシリーズを投入し、最新のTrainium3をすでにクラウドサービスなどで活用している。こうした競合の動向に比べると、Microsoftのカスタムシリコンは2023年11月の「Ignite」で最初の「Maia 100」が発表された後発組となる。しかし、フロンティアAIモデルの急速な普及により推論時のトークン消費量やコストが爆増しているため、クラウド事業者はカスタムシリコンへの取り組みを急いでいる。 料金体系の変化と今後の生産・導入スケジュール 演算コストの増大という悪循環に対応するため、クラウドサービス事業者はUSLと呼ばれる固定料金制から、使った分だけ支払うUBBの従量料金制への変更を進めている。MicrosoftもMicrosoft 365などの固定料金制から、フロンティアAIモデルを利用する「Cowork」や「Autopilot」に関しては従量制料金へと変更を進めているが、顧客からは戸惑いの声が上がっている。こうした中で発表されたMaia 300は、電力あたりのトークン数を増やすことで費用対効果の向上を狙ったものだ。Microsoftによれば、Maia 300の生産開始と導入は2027年の予定で、AzureやMicrosoft 365などのパブリッククラウドやSaaSのAI処理などに活用される計画となっている。

MicrosoftがAzure向けの新型AIアクセラレータ「Maia 300」を発表、2027年から導入予定

Microsoftは10月12日、Azure向けの新型AIアクセラレータ「Maia 300」を発表した。PC Watchの報道によると、前世代の「Maia 200」から約9カ月という短期間での投入となり、2027年から同社のデータセンターなどに順次導入される予定だという。

Maia 300のチップレット構造と最先端プロセスの採用

Microsoftが発表したMaia 300は、複数ダイによるチップレット構造を採用している。Maia 200まではパッケージ上に混載されるHBMを除いてシングルチップ構成だったが、Maia 300ではコンピュートダイ、4つのメモリコントローラダイ、2つのIOダイ、8つの積層HBMなどが1つのパッケージに混載される。メインの演算器となるコンピュートダイは、TSMCの最先端プロセスノードであるN2Pで製造される。メモリも強化されており、Maia 200のHBM3eから、Maia 300ではHBM4で288GBとなっている。メモリ帯域幅もMaia 200の7TB/sから18TB/sへ倍以上に引き上げられた。こうした強化により、MXFP4利用時のスループットは13.8POPSに、FP8利用時は6.9POPSに向上している。

400GbEとラックあたりの搭載数の拡大

Maiaシリーズでは400GbitのEthernetを利用してスケールアップが実現されている。Maia 200では28ポートの400GbEをサポートしていたが、Maia 300では32ポートに増やされている。また、Maia 200では1ラックあたり最大48基までだった格納数が、Maia 300では1ラックあたり最大96基へと倍増した。1つのブレードあたり4基、24ブレード構成となる。ラックあたりの消費電力は167kWに達するが、これによりGPUなどに比べて1メガワットあたりで処理できるトークン数が40%増加すると説明されている。さらに、最大128のラックを1つのスケールアップネットワークとして利用できる「2階層スイッチ」の仕組みも用意され、最大12,288基までの大規模なポッド構成を容易に構築可能になっている。

クラウド事業者におけるカスタムシリコン開発の背景

AIの学習や推論がNVIDIA製GPU上で演算されていることは既知の通りであり、NVIDIAに空前の利益をもたらしている一方で、AIモデル開発や推論環境を提供するクラウドサービス事業者には重い導入コストがのしかかっている。Google Cloudは2016年からTPUを導入しており、今年4月には第8世代のTPU 8tやTPU 8iを発表した。AWSもTrainiumシリーズを投入し、最新のTrainium3をすでにクラウドサービスなどで活用している。こうした競合の動向に比べると、Microsoftのカスタムシリコンは2023年11月の「Ignite」で最初の「Maia 100」が発表された後発組となる。しかし、フロンティアAIモデルの急速な普及により推論時のトークン消費量やコストが爆増しているため、クラウド事業者はカスタムシリコンへの取り組みを急いでいる。

料金体系の変化と今後の生産・導入スケジュール

演算コストの増大という悪循環に対応するため、クラウドサービス事業者はUSLと呼ばれる固定料金制から、使った分だけ支払うUBBの従量料金制への変更を進めている。MicrosoftもMicrosoft 365などの固定料金制から、フロンティアAIモデルを利用する「Cowork」や「Autopilot」に関しては従量制料金へと変更を進めているが、顧客からは戸惑いの声が上がっている。こうした中で発表されたMaia 300は、電力あたりのトークン数を増やすことで費用対効果の向上を狙ったものだ。Microsoftによれば、Maia 300の生産開始と導入は2027年の予定で、AzureやMicrosoft 365などのパブリッククラウドやSaaSのAI処理などに活用される計画となっている。

執筆者について: nipponese

Nipponese News編集部は、国内外のニュースを日本語で分かりやすくお届けします。